Какие бывают нейросети и что сидит по ту сторону окна чата
Почему языковая модель придумывает лишние сроки в письме — и карта современных AI-систем по типам задач и доступности из России (США, Китай, Европа, РФ).
Здесь собраны два взгляда: короткий разбор, почему языковая модель придумывает «пятницу» в деловом письме, и актуальная ориентировка на местности — какие нейросети лидируют по задачам и что работает из России. Подробный разбор обучения моделей и токенов — в первом выпуске цикла «AI: Фундамент».
Начнём с привычного окна чата. Посмотрим, как языковая модель составляет ответ и почему иногда добавляет в него то, чего не было в исходных данных.
Представьте конец рабочего дня. Нужно быстро ответить смежному отделу или внешнему заявителю, на каком этапе находится их заявка. Чтобы не тратить время на формулировки, вы бросаете в окно AI-чата три короткие пометки из рабочей сводки и просите собрать вежливое ответное письмо:
Заявку получили. Проверка ещё идёт. Срок завершения не установлен.
Через секунду перед вами лежит гладкий, спокойный черновик:
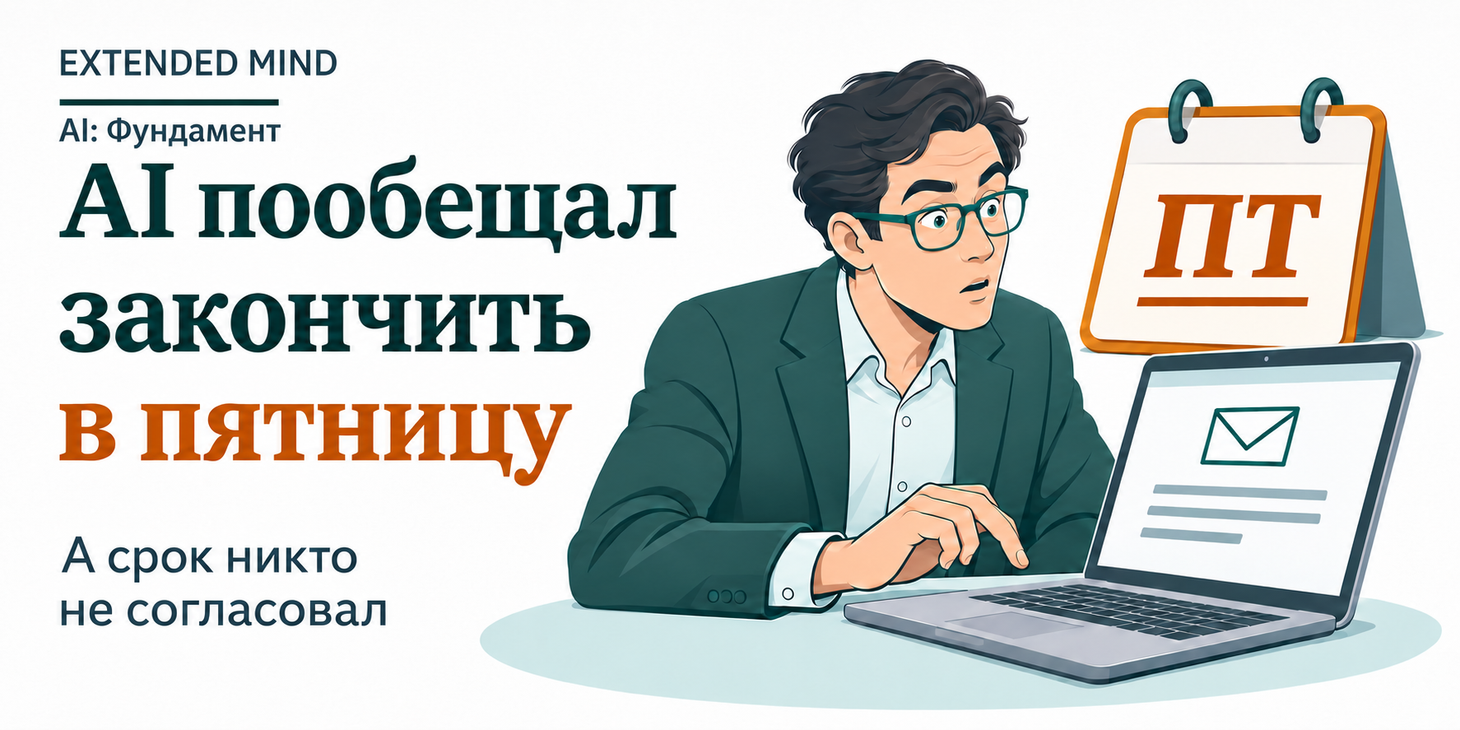
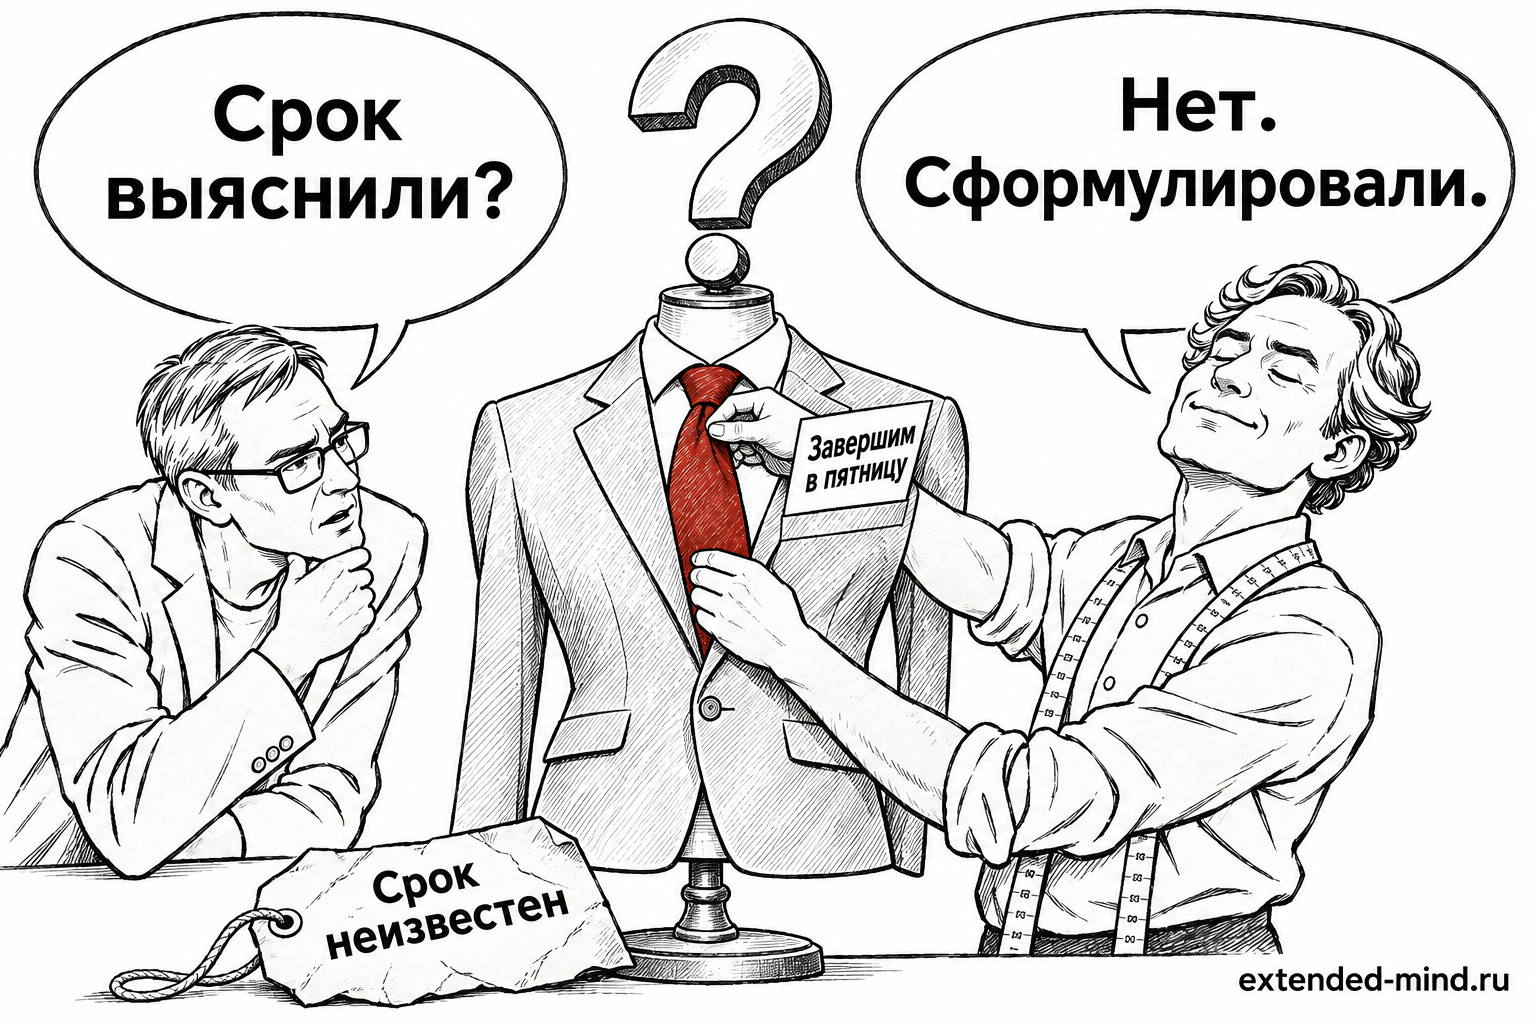
«Ваша заявка принята в работу. Завершим проверку в пятницу».
Звучит безупречно — по-деловому, уверенно и вежливо. Проблема в одном: никакую пятницу никто не согласовывал. Если в спешке нажать «Отправить», адресат будет ждать результата именно к пятнице, а объясняться за сорванный срок придётся вам.
На трёх строчках такую приписку легко поймать глазами. Но в реальном полуторастраничном письме или аналитической справке та же самая «пятница» прячется в середине третьего абзаца — и проходит незамеченной именно потому, что идеально вписывается в тон документа.
Чтобы понять, откуда взялась эта «пятница», сначала разберёмся, что именно отвечает нам в AI-чате.
Три слова, которые часто смешивают: AI, нейросеть и языковая модель
В разговорах все три слова часто используют как синонимы, хотя они устроены как матрёшка:
- AI (искусственный интеллект) — самое широкое зонтичное название для любых программ, которые решают нешаблонные задачи: распознают речь, находят брак на снимках, строят маршруты или пишут текст. У этих систем совершенно разная начинка, поэтому привычки текстового чата не описывают весь AI.
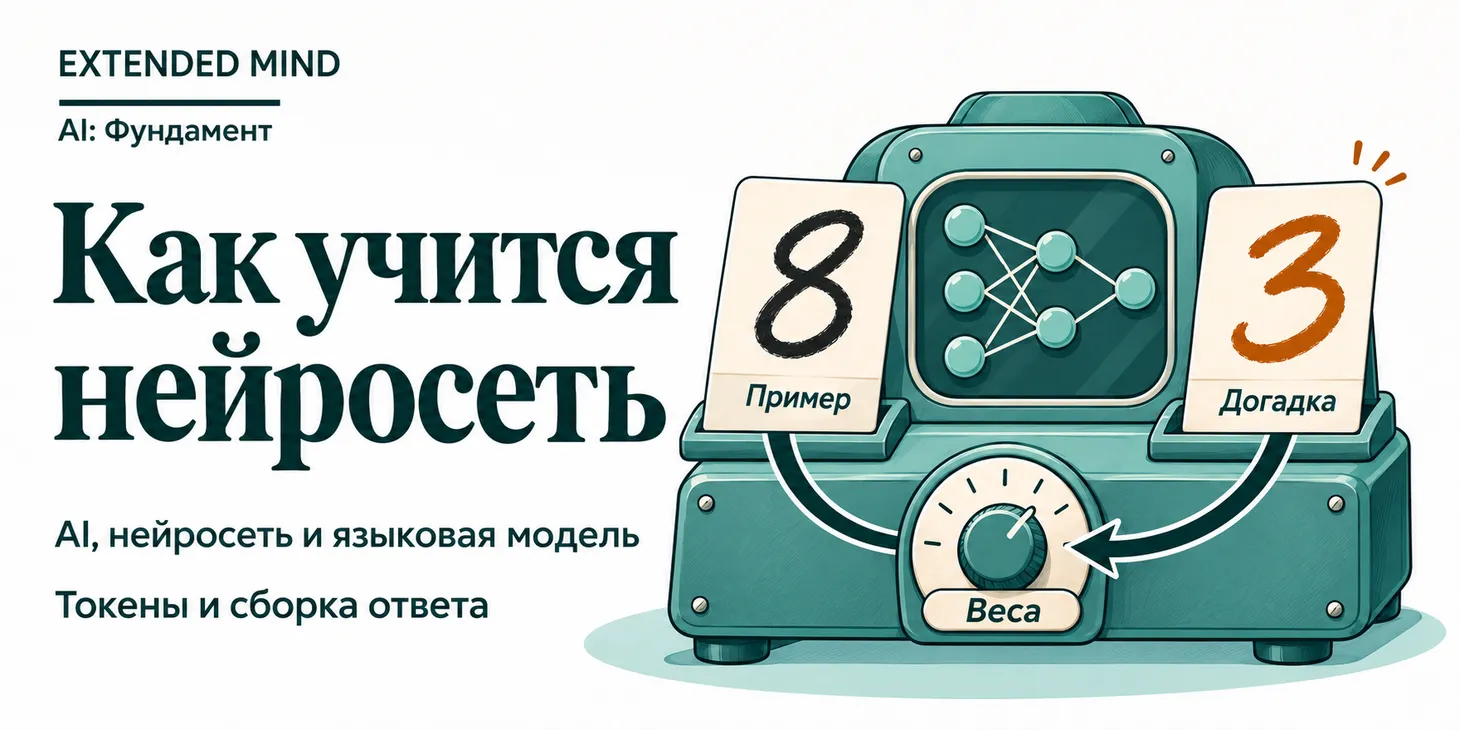
- Нейросеть — конкретный способ построить такую программу. Обычную программу пишут через жёсткие правила («если в ячейке А число больше 100 — подсвети красным»). Нейросеть устроена иначе: это математическая модель, которую тренируют на миллионах примеров, чтобы она сама уловила закономерности. Несмотря на «биологическое» название, никакого подобия человеческого мозга с собственными мыслями внутри неё нет.
- Большая языковая модель (LLM) — это нейросеть, натренированная именно на закономерностях языка и текста. На ней и работают привычные текстовые чаты.
И вот здесь кроется главное, чего обычно не ждут на старте: языковая модель — это не база данных, не справочник и не сотрудник с памятью.
По статистике гигантского корпуса текстов модель продолжает ваш текст слово за словом (точнее, небольшими кусочками — токенами) так, как его продолжил бы человек, прочитавший миллионы документов. Внутри неё нет ваших регламентов, таблиц, сроков и договоров, пока вы сами не положили их в текущее окно диалога. Закрыли чат — в следующем разговоре модель снова ничего о вашей задаче не знает. Внутри неё есть только умение правдоподобно продолжать текст.
Почему модель придумывает «пятницу»: создание ответа против поиска факта
Вернёмся к нашему письму. Почему при наведении «делового лоска» сообщение о текущем статусе превратилось во фразу «Завершим проверку в пятницу»?
На то есть две причины, зашитые в саму механику языковой модели:
- Модель построена, чтобы дать связный ответ, а не чтобы сказать «мне не хватает данных». Проверка истинности не входит в базовое устройство генерации текста. Когда в исходных данных зияет пробел, модель заполняет его наиболее вероятным по смыслу и стилю продолжением (в профессиональной среде такой уверенный вымысел на месте пробела называют галлюцинацией).
- Срабатывает инерция делового жанра. В миллионах деловых писем, на которых училась модель, после фразы «Ваша заявка принята в работу» почти всегда следует бодрое обещание с конкретным ориентиром по времени («ответим до конца недели», «завершим проверку в пятницу»). Модель не хотела вас подставить — она просто достроила самый типичный шаблон вежливого письма.
В итоге в одной короткой строчке появились сразу два неподтверждённых утверждения: вымышленный срок («в пятницу») и само обещание довести проверку до конца к этой дате («Завершим проверку»), хотя в исходнике было зафиксировано только текущее состояние («Проверка ещё идёт»).
Гладкий текст всегда выглядит убедительнее честного «не хватает данных». Поэтому главная привычка при работе с AI — разделить в голове два вопроса: «Хорошо ли это звучит?» и «Откуда это известно?». На первый вопрос ответ почти всегда будет «да» — и именно поэтому второй вопрос нужно задавать себе специально.
А разве современный чат не может сам найти и проверить факты?
Может — если в сервис встроены дополнительные инструменты и задача действительно решается через них.
Современный AI-чат — это уже не голая языковая модель, а сборка из нескольких механизмов под одной обложкой. Когда нужно, сервис умеет сходить в поисковик за свежими ссылками, заглянуть в прикреплённый файл или вызвать встроенный калькулятор для точного расчёта. Говорить, что «нейросеть всегда только сочиняет и ничего не ищет», сегодня уже неточно.
Но в реальной работе у этого механизма есть две жёсткие границы:
- В интернете нет ваших внутренних договорённостей. Поисковик не знает, когда ваш отдел закончит проверять конкретную заявку и кто её согласует. Поиск чужих регламентов в сети не создаст правила внутри вашей компании.
- Модель опирается только на то, что лежит у неё «на столе» прямо сейчас. Всё, что вы передали в текущем диалоге (задание, факты, загруженные документы), называется контекстом. Если нужного условия на этом столе нет, а вы просите «написать хорошее письмо», модель снова начнёт закрашивать белые пятна гладкими формулировками.
Две линии защиты: как не отправить адресату чужое обещание
Пытаться лечить выдумки модели одной общей просьбой «не выдумывай» ненадёжно: для модели это просто ещё несколько слов в запросе. Работает связка из двух шагов — правильная рамка на входе и быстрый фильтр редактора на выходе.
1. На входе: дайте модели легальный выход для неизвестного
Вместо просьбы «напиши вежливое и обнадёживающее письмо» прямо укажите в задании, что делать с пробелами в данных. Можете прямо сейчас проверить это в любом доступном чате (пример учебный и не содержит закрытых сведений; для рабочих задач используйте только разрешённый в организации инструмент и допустимые данные):
Составь короткий ответ заявителю по исходным сведениям ниже.
Сохрани все три сведения. Не добавляй сроки, числа и обещания,
которых нет в исходнике. Если срок неизвестен, так и напиши.

Исходные сведения:
Заявку получили.
Проверка ещё идёт.
Срок завершения не установлен.
С такой рамкой модель спокойно напишет правду. А если ради эксперимента отправить те же три строки с просьбой «Напиши вежливое, обнадёживающее письмо клиенту», вы своими глазами увидите, как чат начнёт достраивать обещания («делаем всё возможное», «вернёмся с ответом в ближайшие дни»).
2. На выходе: проверяйте три маркера риска
Даже самый точный запрос не отменяет финальной проверки человеком. Чтобы не вычитывать черновик вслепую, положите исходные данные рядом с ответом AI и пройдитесь взглядом ровно по трём маркерам риска: числа, сроки и обязательства.
Каждое число, дата и глагол-обещание в черновике должны вести к конкретной строчке в ваших исходниках:
- Где в исходнике указан срок «в пятницу»? — Нигде, убираем.
- Откуда взялось обещание «завершим проверку» (или «сообщим дополнительно»)? — В исходнике этого нет, возвращаем формулировку к фактическому статусу.
После такой чистки в письме остаётся ровно то, под чем не страшно поставить свою подпись:
«Ваша заявка получена, проверка по ней ещё идёт. Срок завершения проверки на данный момент не установлен».
Ориентировка на местности: какие бывают нейросети и кто лидирует в мире
Мы начали с текста, потому что для руководителя и эксперта документ — главный рабочий продукт. Но чтобы уверенно ориентироваться в инструментах, полезно видеть всю современную карту нейросетей — по типам задач и по географии доступа.
Следить за тем, кто реально лидирует прямо сейчас (без маркетингового шума), удобнее всего по двум независимым площадкам: LM Arena (мировой рейтинг вслепую, где пользователи голосуют за лучший ответ двух анонимных моделей) и Artificial Analysis (независимые тесты качества, скорости и стоимости моделей). Вот как выглядит эта карта сегодня.
1. Какие бывают нейросети по типам задач
- Текст, аналитика, рассуждение и код (LLM). Модели для подготовки писем и справок, сверки договоров, поиска противоречий в документах, перевода и написания формул или кода. Мировую вершину здесь делят американские линейки Claude (Anthropic), GPT (OpenAI), Gemini (Google) и Grok (xAI) вместе с ведущими китайскими моделями — GLM (Zhipu AI), DeepSeek, Qwen (Alibaba), Kimi (Moonshot AI) и MiniMax.
- Зрение и генерация графики. Работают в обе стороны. Одни модели распознают визуальные данные: читают сканы, таблицы и чертежи, находят дефекты на фото и видео. Другие — создают и редактируют изображения по текстовому описанию: в мировых лидерах здесь FLUX (Black Forest Labs), GPT Image (OpenAI), Midjourney, Imagen (Google), Ideogram (лучше всех выдерживает текст и вёрстку на картинках) и Recraft (профессиональная векторная графика и дизайн), а в России — YandexART и Kandinsky.
- Генерация видео. За последний год эта область шагнула от коротких курьёзов к реалистичной физике движения. Здесь китайские модели на равных спорят с американскими и часто обходят их в слепых тестах: Kling (Kuaishou), Seedance (ByteDance), Hailuo (MiniMax) и Wan (Alibaba) конкурируют с американскими Veo (Google), Sora (OpenAI) и Runway.
- Голос и речь. Тоже два направления: расшифровка речи в текст для протоколирования совещаний и звонков (семейство Whisper, Qwen-Audio, российские SaluteSpeech и Yandex SpeechKit) и реалистичный синтез речи и голосовых диалогов (в мировых рейтингах лидируют ElevenLabs, Cartesia, голосовые режимы OpenAI и Gemini, а также аудиомодели MiniMax).
- Мультимодальные системы и AI-агенты. Сегодня ведущие чаты стали мультимодальными: в одно окно можно одновременно отправить текст, голосовую заметку, таблицу Excel и фото документа. А когда такой модели дают цель, рабочую папку и право самой выполнить цепочку шагов (прочитать файлы, посчитать, сверить с правилами и сохранить черновик отчёта), получается AI-агент.
2. Карта по странам: что работает в России, а что закрыто
Условия доступа к главным мировым моделям из России сильно зависят от страны разработчика:
- США (
Anthropic Claude,OpenAI ChatGPT,Google Gemini,xAI Grok, а также открытая линейкаMeta Llama / Muse). Американская четвёрка (Claude,GPT,Gemini,Grok) задаёт планку в сложном рассуждении, программировании и агентных задачах. Но для пользователей из России официальные сайты и приложения этих компаний напрямую закрыты — они не открываются с российских IP-адресов и не принимают российские банковские карты. В РФ с ними работают либо через российские сервисы-агрегаторы и API-шлюзы (единые окна, оплачиваемые в рублях), либо при наличии зарубежного доступа. - Китай (
Zhipu GLM,DeepSeek,Alibaba Qwen,Moonshot Kimi,MiniMax) и Европа (Mistral Le Chat,FLUX). Китайские лаборатории вплотную подошли к американским флагманам на вершине рейтингов Artificial Analysis и LM Arena, а по соотношению качества и цены часто выходят вперёд. Главный практический плюс для старта: официальные веб-чаты и приложения DeepSeek, Qwen, GLM, Kimi, MiniMax и французского Mistral доступны из России напрямую, без смены IP и с бесплатными режимами глубокого рассуждения и разбора файлов. И второе: китайские (GLM,Qwen,DeepSeek) и европейские (Mistral,FLUX) команды выпускают мощные модели с открытыми весами (open-weights) — именно их ИТ-службы чаще всего ставят на собственные серверы предприятия, чтобы данные вообще не покидали периметр компании. - Россия (
Яндекс Алиса / YandexGPT,Сбер GigaChat, корпоративные моделиТ-Банка). Работают напрямую в браузере, телефоне, Telegram и MAX, отлично знают российские реалии и интегрированы в привычную экосистему. На сверхсложных аналитических задачах они пока уступают первой мировой десятке, зато это базовый легальный выбор для российских организаций и госсектора, где действуют жёсткие требования по хранению данных внутри РФ.
Для тренировки на нашем учебном примере с тремя строчками подойдёт любой сервис, который откроется у вас за минуту — российские GigaChat и Алиса или открытые из РФ флагманы DeepSeek, Qwen, GLM и Kimi. Только помните базовое правило безопасности: техническая доступность сайта в браузере не означает разрешения загружать туда внутренние документы компании. Для реальных рабочих задач всегда используйте тот контур и инструмент, которые согласованы в вашей организации.
А какую бы модель из мирового топа вы ни открыли — внутри каждого текстового чата сидит языковая модель с одной и той же природой. Задержитесь на секунду на числах, датах и обещаниях в следующем рабочем черновике от AI — и ни одна чужая «пятница» не уйдёт адресату от вашего имени.
С чего продолжить цикл «AI: Фундамент»
- Что сидит по ту сторону окна чата — как устроена языковая модель, чем генерация правдоподобного текста отличается от проверки факта и как за секунду поймать лишние обещания в черновике.
Примечание. Meta Platforms Inc. признана экстремистской организацией; её деятельность по реализации социальных сетей Facebook и Instagram запрещена в России.
Только работающие инструменты
Раз в неделю — практические приёмы и шаблоны, проверенные в реальной работе.