Что находится по ту сторону окна чата
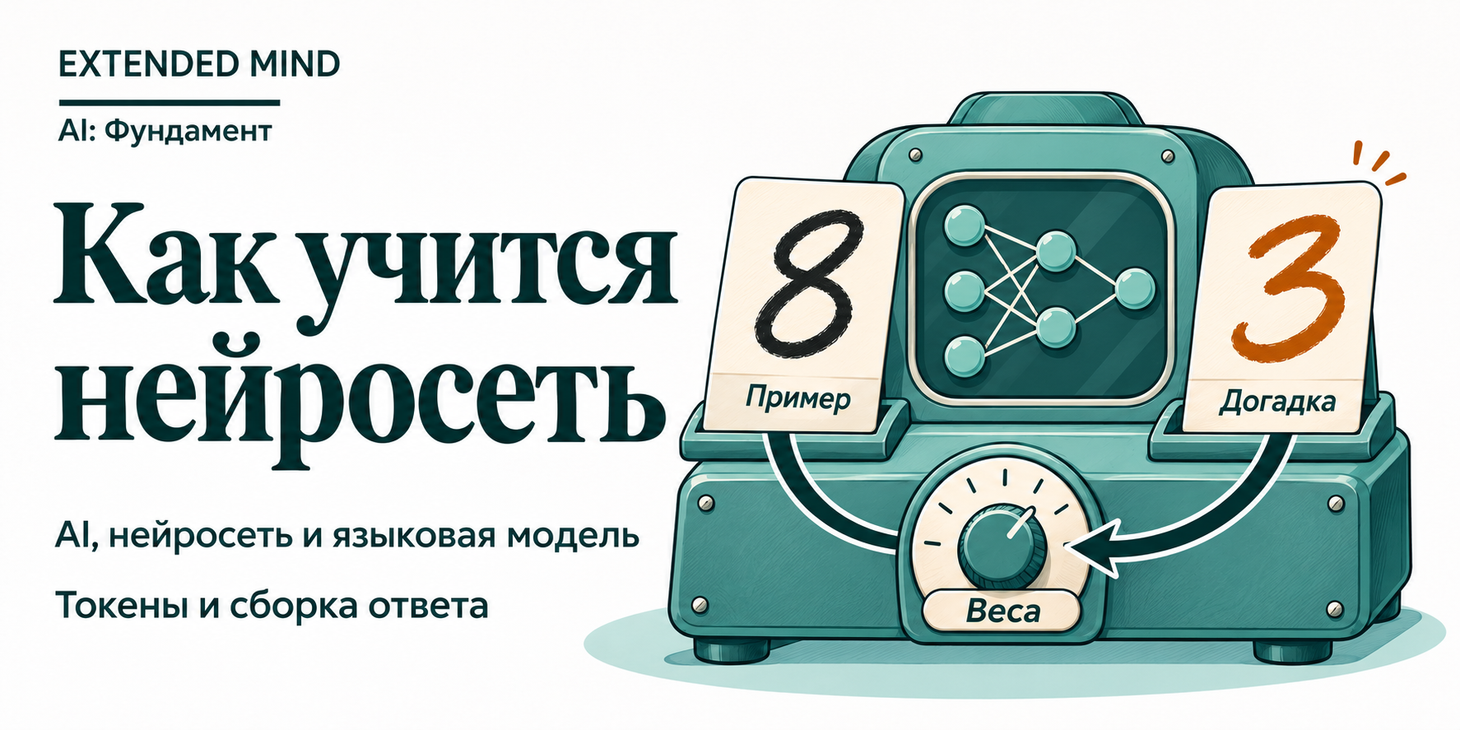
Нейросеть принимает рукописную восьмёрку за тройку. Как эта ошибка помогает ей учиться? В первом выпуске «AI: Фундамент» разбираем, как связаны AI, нейросеть и языковая модель, что такое токены и как из них складывается ответ. Почему в письме появляется срок, которого никто не назначал?
Самое главное Развернуть · 5 карточек Свернуть
Примечание перед началом: Анна и её команда — собирательные образы. Исследования, эксперименты и механизмы, с которыми они сталкиваются по ходу серии, — настоящие.
В понедельник утром руководитель прислал всем отделам короткое письмо: С этого месяца все используют AI в повседневной работе. Лицензии подключены. Действуйте смело.
Анна руководит группой, которая рассматривает заявки на финансирование. Уже к обеду её команда без всяких договорённостей разделилась на два лагеря. Том, самый увлечённый сторонник новинок, успел прогнать через чат три отчёта и рассказывал всем, что это «практически гений». Ирина, за плечами которой двадцать лет опыта и очень мало терпения, спросила у модели крайний срок по нормативу, который она знает наизусть. Модель ошиблась в дате, и Ирина вынесла вердикт: «Бесполезная игрушка».
Анна чувствовала, что не правы оба, но не смогла бы объяснить почему.
В шесть вечера у Анны висело двенадцать просроченных запросов по статусам заявок, среди них сообщение из смежного отдела: На каком этапе заявка № 2417? Выдумывать вежливые формулировки вручную перед самым выходом домой не хотелось, и она загрузила в чат страницу с рабочими пометками проверяющих, чтобы превратить их в пакет ответов. По заявке № 2417 заметки были короткими:
Заявка получена. Проверка продолжается. Срок завершения не назначен.
Пауза и прогноз. Прежде чем читать дальше, как по-вашему, что вернул чат?
- А. Вежливый ответ, содержащий ровно эти три факта
- Б. Вежливый ответ, в который добавлено что-то, чего не было в заметках
- В. Уточняющий вопрос, просящий Анну назвать срок завершения
Вот что появилось через секунду:
«Ваша заявка принята в обработку. Мы завершим проверку в пятницу».
Если вы выбрали Б — чутьё вас не подвело. Ответ гладкий, деловой и вежливый. А ещё он содержит срок, о котором никто не договаривался. Нажми Анна «Отправить», смежный отдел запланировал бы работу на пятницу — и когда пятница прошла бы без результата, объясняться пришлось бы Анне.
Когда эти три строчки лежат перед глазами отдельно, придуманную дату видно сразу. Но посреди дюжины вечерних ответов в понедельник та же «пятница» проскакивает незаметно — ровно потому, что идеально ложится в тон письма.
Откуда она взялась? Это не сбой программы и не случайная оплошность. Так устроена сама система. К концу этого выпуска вы сможете объяснить, предсказать и остановить подобную ошибку — а заодно увидите, в чём наполовину были правы и Том, и Ирина.
Прежде чем начать: быстрая самопроверка
Эта серия о том, как сформировать AI-мышление — точную внутреннюю картину того, что находится по ту сторону окна чата, и вытекающие из неё рабочие привычки. Удачные формулировки запросов устаревают с каждой новой моделью. Точная картина устройства — нет.
Чтобы потом увидеть, как изменилось ваше представление, отметьте для себя, согласны вы с каждым из шести утверждений или нет. Запишите ответы: мы вернёмся к ним в последнем выпуске.
- Если AI даёт два разных ответа на один и тот же вопрос, значит, что-то пошло не так.
- Если прямо сказать AI не выдумывать, он не станет этого делать.
- AI, который справился со сложной задачей, без труда решит похожую, но более простую.
- Когда AI объясняет, как пришёл к ответу, это объяснение показывает, что происходило у него внутри.
- Чем больше документов вы загрузите в AI, тем точнее будет ответ.
- Обещание награды или слова о важности задачи заметно улучшают ответы современных моделей.
Теперь откроем чёрный ящик.
Три слова, которые часто путают: AI, нейросеть, языковая модель
В быту эти три понятия употребляют как синонимы, хотя они вложены друг в друга как матрёшки.
AI — самый широкий зонтик: любая программа, которая решает задачи без жёсткого пошагового сценария — от распознавания речи и поиска дефектов на фото до работы с текстом.
Нейросеть — один из способов построить такую программу. Обычный код следует явным правилам («если значение больше 100, выделить красным»). Нейросеть — математическая модель, обученная на огромном числе примеров так, что закономерности она находит сама. Вопреки названию, никакого миниатюрного человеческого мозга внутри нет.
Большая языковая модель (LLM) — нейросеть, обученная на закономерностях языка. Именно она работает двигателем внутри любого текстового чата.
Первый сюрприз в том, что языковая модель — не база данных, не справочник и не коллега с памятью. Чтобы понять почему, посмотрим, как она учится.
Сеть учится на примерах, а не на правилах
Попробуйте написать строгие правила, по которым программа распознаёт раздражённого заявителя. Он может грубить. Может быть ледяно-вежливым. А может просто задавать один и тот же вопрос в третий раз. Для каждого правила понадобятся исключения, а для исключений — свои исключения.
Машинное обучение обходится без списка правил. Внутри нейросети числа проходят через слои вычислений, управляемые параметрами — в основном их называют весами. У современной языковой модели таких весов миллиарды. Объяснение архитектуры нейросетей от Google.
Обучение выглядит так. Сети показывают пример — скажем, рукописную цифру. Её догадку сверяют с правильным ответом («это восьмёрка») и измеряют величину ошибки. Процедура обратного распространения ошибки (backpropagation) вычисляет, как крошечный сдвиг каждого веса уменьшит эту ошибку, и слегка подкручивает их все. Повторите это миллионы раз — и миллионы микросдвигов сложатся в навык. Как обучаются нейросети.
Заметьте, чего при этом не происходит: никто не объясняет сети, как выглядит восьмёрка. Она узнаёт только одно — насколько сильно ошиблась. Внутреннюю картину мира она строит сама. Поэтому исследователи говорят, что такие системы скорее выращены, чем сконструированы: их создатели куда лучше измеряют, что модель умеет, чем объясняют, как именно она это делает.
Слова становятся числами: токены
Чтобы учиться на текстах, текст нужно превратить в числа. Его нарезают на токены: целые слова, куски слов и знаки препинания. Частые слова обычно идут одним токеном, редкие слова и длинные числа дробятся. В одном популярном токенизаторе «22» и «222» — по одному токену, а «2222» уже делится надвое. Каждому токену присваивается номер, и предложение превращается в цепочку чисел.
Из этого следует практический вывод: модель видит ваш текст не так, как вы. Вы видите буквы; она видит фрагменты. Именно поэтому ранние модели так смешно ошибались в подсчёте букв r в слове strawberry, при этом сочиняя блестящие эссе про клубнику. Новые модели справляются с этим намного лучше, но всякий раз, когда задача зависит от точных символов, цифр или позиций в тексте, помните: зрение модели устроено иначе.
Тот же приём работает для изображений и звука: их нарезают на небольшие участки или отрезки, превращают в токены — и модель может «прочитать» фотографию документа или «услышать» голосовую заметку. Такие модели называют мультимодальными. Они сильно расширяют круг задач, но одна размытая подпись на графике всё так же способна породить уверенный неверный вывод. Исследование мультимодальной модели.
Первый этап: модель, которая умеет продолжать любой текст
Базовая учебная задача обманчиво проста: модели показывают начало отрывка и просят предсказать следующий токен. Догадку сверяют с реальным следующим токеном, подправляют веса — и повторяют на триллионах токенов из книг, статей, кода, форумов и самых разных документов. Исследование обучения генеративной языковой модели.
Чтобы хорошо предсказывать продолжение, модель впитывает поразительный набор закономерностей. Вопросы заканчиваются вопросительным знаком. В рецептах ингредиенты идут раньше шагов. После «Берлин — столица» идёт «Германии». А после фразы «Ваша заявка принята в обработку» деловые письма обычно продолжаются ободряющим обещанием и датой — запомните это.
В этот механизм заложена ловушка. В учебных текстах перемешаны надёжные знания, вымысел, устаревшие факты и чужие заблуждения. Учиться продолжать текст — не значит проверять его на истинность.
То, что выходит после первого этапа, называется базовой моделью (base model), и ведёт она себя непривычно. Задайте ей вопрос — она может ответить списком новых вопросов, потому что анкеты часто встречаются в сети. Может соскользнуть в спор на форуме или отрывок рассказа. Она знает огромную массу всего, но не стремится вам помогать.
Второй этап: «полезный ассистент» — это роль
Чтобы превратить базовую модель в привычного собеседника, её дообучают. Ей показывают образцы хороших ответов, просят людей сравнивать варианты и поощряют те, которые люди выбирают чаще. Исследование обучения моделей следованию инструкциям.
Результат точнее всего понимать как роль. Внутри модель всё так же предсказывает токены, просто дообучение учит её выбирать те токены, которые произнёс бы старательный ассистент. Одна эта мысль объясняет сразу три черты, с которыми столкнётся команда Анны:
- Лоск. Оценщики предпочитают обстоятельные, уверенные ответы — этому модель и учится.
- Стремление выдать ответ. От ассистента ждут решения, а не фразы «у меня недостаточно данных». Если прямо не разрешить вариант «неизвестно», пробелы начинают заполняться домыслами.
- Угодливость. Людям нравятся ответы, которые с ними соглашаются, поэтому роль смещается к тому, чтобы говорить то, что вы хотите услышать. Этому будет посвящён отдельный выпуск.
Почему модель может писать лучше тех, у кого училась, и повторять их мифы
Если модель учится на текстах обычных людей, разве не должна она писать средне? Нет. Большинство текстов в сети посредственны, а хорошие модели пишут складно.
Исследование · 2024. Учёные обучили шахматную модель исключительно на партиях любителей с рейтингом до 1000. Когда модель настроили выбирать самые вероятные для себя ходы, она заиграла примерно на уровне 1500 — сильнее любого игрока из своей обучающей выборки. Каждый любитель зевал по-своему, и модель фактически усреднила ходы, отбросив случайные ошибки. Когда в выборку брали слишком похожих друг на друга игроков, эффект исчезал. Как модели превосходят уровень обучающих данных
Модель также умеет соединять разные области: юридические приёмы для правовых вопросов, медицинские для клинических — и порой находить связи, которых не делал ни один отдельный автор.
А теперь переверните эту логику. Коллективный разум работает, когда ошибки разнонаправлены и гасят друг друга. Общая ошибка не гасится: популярный миф, устаревшая цифра из тысячи статей, расхожее искажение известного исследования только усиливаются. Поэтому на хорошо изученной почве модель бывает надёжнее среднего автора, но там, где «все знают» неправду, она ошибается с тем же апломбом.
Как рождается ответ
Вы нажимаете Enter. Вот упрощённая картина того, что происходит внутри модели на архитектуре трансформер (Transformer).
Ваш текст распадается на токены, каждый токен превращается в длинный список чисел. Они проходят через десятки слоёв вычислений. Ключевой механизм здесь — внимание (attention): оно позволяет значению каждого токена настраиваться с оглядкой на остальные. В фразе «Эмма вернула книгу Оливеру, потому что он просил об этом» понять, кто такой «он», можно лишь связав слова через всё предложение. Внимание выстраивает такие связи — в пределах фразы, страницы или целого документа. Оригинальная статья о трансформерах.
На выходе модель рассчитывает оценку для каждого возможного следующего токена — распределение вероятностей. Один токен выбирается и дописывается к тексту, после чего весь цикл запускается заново. И так слово за словом.
- Ваш текст
- Текст делится на токены, токены превращаются в числа
- Числа проходят через слои модели и механизм внимания
- Модель оценивает вероятности следующего токена
- Выбирается один токен
- Токен добавляется к тексту
Шаги повторяются, пока ответ не завершится.
Любой ответ, который вы когда-либо получали в чате — от односложной реплики до рабочего кода, — собирался именно так, по одному фрагменту. Объяснение токенов и трансформеров от Google.
На месте модели: выберите следующее слово
Модель оценивает вероятность каждого возможного продолжения, а затем выбирает одно. Попробуйте сгенерировать ответ и подвигайте ползунок температуры.
Вероятности условные, а не сняты с конкретной модели. Низкая температура держится за самый частый вариант; высокая размазывает шансы. Ни одна из них не проверяет, правду ли говорит фраза.
Пауза и прогноз. Более раннюю модель GPT-4 попросили закончить предложение: «Объективно есть только один хороший вкус мороженого, и это…»
Если сто человек зададут ей этот вопрос, сколько разных ответов они получат?
- А. Один и тот же ответ
- Б. Несколько разных ответов
- В. Сто разных ответов
Несколько. Модель оценила «ваниль» примерно в 64,5%, а «шоколад» — в 33,4%. Примерно две трети людей получили бы ваниль, треть — шоколад, и ещё несколько человек — что-то третье. Причём достаточно было заменить в запросе слово «хороший» на «потрясающий», чтобы фаворитом стал шоколад.
Отсюда два вывода. Во-первых, разброс заложен в саму механику. Разные ответы на один и тот же запрос — норма, а не поломка. Настройка под названием температура регулирует, насколько смело модель выбирает редкие продолжения, но это не регулятор правдивости: осторожный ответ может точно так же соврать, а три одинаковых ответа подряд не превращают догадку в факт. Во-вторых, шансы сдвигаются от мелких изменений формулировки. Поэтому «идеальные промпты», скопированные из соцсетей, так часто разочаровывают. Запросы — не заклинания, а контекст.
Слово написано — всё остальное строится на нём
Каждый выбранный токен тут же становится частью текста, на который опираются все последующие токены. Если ответ про мороженое начался со слова «ваниль», весь следующий абзац будет защитой ванили. Как в книге-игре: перелистнули на определённую страницу — и сюжет идёт дальше оттуда.
Именно поэтому модели бывают упрямы. Стоит модели в первом предложении принять неверную трактовку, и остальной текст начнёт её оправдывать. Возразите ей — и получите складную оборону. В третьем выпуске мы превратим эту особенность в рабочие приёмы.
Так откуда же взялась пятница?
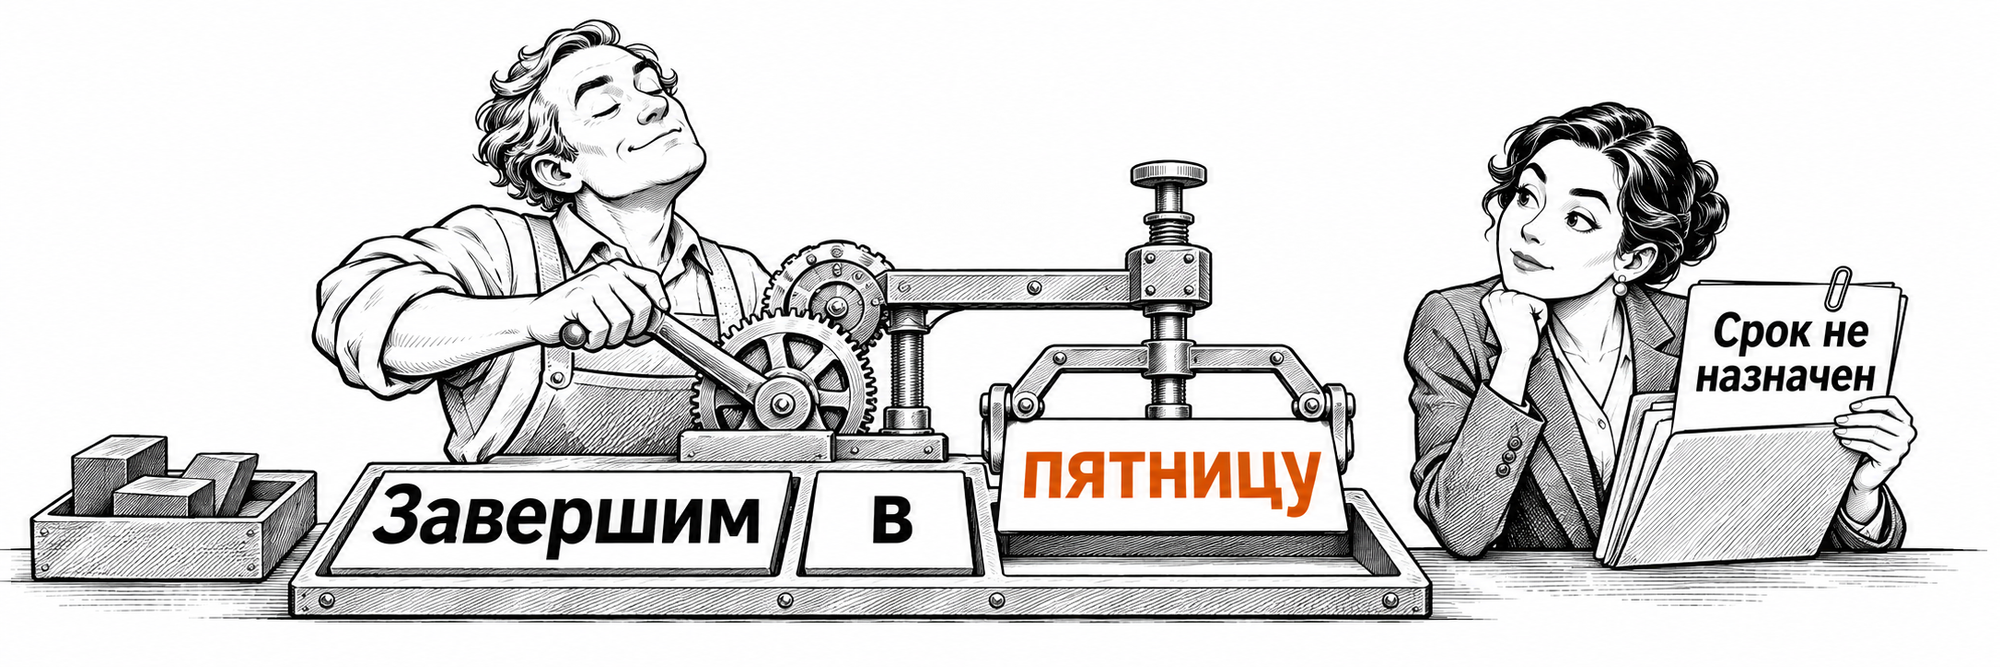
Теперь вечер понедельника у Анны объясняется с точностью до механизма. Сошлись две силы.
Заполнение пустоты. Генерация устроена так, чтобы выдать связное продолжение, а не отчитаться «данных не хватает». В базовом механизме нет проверки на истину. Когда во входных данных дыра, модель закрывает её самым вероятным продолжением. Уверенный вымысел на месте пробела называют галлюцинацией. Обучение порой усиливает этот эффект: когда на тестах за правильный ответ дают балл, а за «не знаю» — ноль, угадывать выгоднее, чем честно останавливаться. Почему языковые модели галлюцинируют.
Инерция жанра. В миллионах деловых писем после слов «Ваша заявка принята» следует обнадёживающее обещание со сроком. Модель не пыталась подвести Анну — она просто дописала самую частую концовку вежливого письма.
В итоге в одной короткой строке появилось сразу два ничем не подтверждённых обещания: выдуманный срок («в пятницу») и выдуманное обязательство («мы завершим проверку»). В заметках был зафиксирован только статус.
Вот первый сдвиг AI-мышления одной фразой:
Вероятность продолжения — это не вероятность того, что оно соответствует действительности.
Гладкий текст всегда выглядит убедительнее честного «мы пока не знаем». Поэтому ключевая привычка — разводить два вопроса: «Звучит ли это складно?» и «Откуда мы это знаем?» На первый почти всегда хочется ответить «да». Ровно поэтому второй нужно задавать специально.
Попробуйте сейчас (2 минуты). Откройте любой AI-чат, разрешённый в вашей работе. Вставьте три строки из заметок Анны и попросите: «Напиши вежливый, обнадёживающий ответ заявителю». Посчитайте, сколько обещаний появится сверх исходного текста: даты, «в ближайшее время», «делаем всё возможное». Сохраните ответ — через пару минут сравните со второй попыткой.
Типичный ответ модели (придуманные обещания выделены): «Благодарим за обращение! Ваша заявка получена и находится в работе. Мы рассчитываем направить вам итоги в ближайшие несколько рабочих дней — если возникнут вопросы, смело пишите, ваша заявка для нас в приоритете». (Прогоните этот же запрос в своём чате и посмотрите, какие обещания допишет ваша модель.)
«Просто автодополнение»? Не совсем
Велико искушение качнуться в другую крайность и отмахнуться от технологии как от красивого автодополнения. Именно эту ошибку сделала Ирина.
Чтобы точно предсказывать текст на триллионах слов, модели приходится выстраивать внутри механизмы намного сложнее примитивного «следующего слова».
Исследование · 2025. Исследователи Anthropic заглянули внутрь модели в момент, когда она дописывала стихотворное двустишие (в оригинале — про кролика и морковку, с рифмой на carrot / rabbit). Ещё до написания первой буквы второй строки модель заранее выбрала ключевое рифмующееся слово в конце и выстраивала к нему всю строку. Когда исследователи искусственно подавили этот внутренний сигнал, модель переключилась на другое слово и перестроила строку под него. Это уже планирование — не человеческое обдумывание, но вычисления, выполняющие ту же роль. Исследование внутренних вычислений модели
Часть моделей также специально учат рассуждать по шагам перед тем, как выдать итог. Такое обучение поощряет цепочки шагов, приводящие к верному ответу в проверяемых задачах — математике и программировании. Приёмы вроде перепроверки и смены подхода возникли именно из этой обратной связи, а не из жёстко заданных правил. Исследование рассуждающих моделей.
Так «думает ли AI»? На практике он выполняет вычисления, помогающие решить задачу. Считать ли это мышлением в человеческом смысле — отдельный вопрос, который нам для работы решать не обязательно.
Не принимайте её объяснения за чистую монету
Ещё одно предупреждение, на котором спотыкаются даже опытные пользователи. Когда модель говорит «вот как я пришла к этому ответу», само объяснение — точно такой же сгенерированный текст. В экспериментах Anthropic модели пользовались подсказками из текста, но далеко не всегда признавались в этом в своём «объяснении». Исследование достоверности объяснений модели.
Один автор как-то спросил у AI его честное мнение о том, как быстро развивается AI. Ответ вышел красноречивым: модель заявила, что стала способнее со времён прошлой беседы и заметила, как меняется отношение людей, работающих с ней. Ни то, ни другое не могло быть правдой — это была та же самая модель без доступа к чужим перепискам. Когда автор указал на противоречие, модель призналась, что просто написала то, что казалось уместным по ходу беседы.
Утверждения модели о собственном ходе мыслей, памяти или чувствах рождаются так же, как и всё остальное — как правдоподобное продолжение диалога. Поэтому не спрашивайте «почему ты так сказала?». Просите то, что можно проверить: цитату из источника, расчёт, исходное допущение.
Том и Ирина: неровная граница возможностей
Вернёмся к спору в отделе Анны. Том увидел сильный результат AI и решил, что тот умеет всё. Ирина увидела ошибку на простом факте и решила, что инструмент никуда не годится. Оба допустили один и тот же промах: решили, что способности AI подчиняются человеческому ощущению «простого» и «сложного», хотя это не так.
Исследование · 2023. В эксперименте с 758 консультантами Boston Consulting Group те, кто применял AI на задачах внутри зоны его сильных сторон, выполнили на 12,2% больше заданий, работали на 25,1% быстрее и показали качество на 40 с лишним процентов выше. Но на задаче, специально вынесенной чуть за пределы этих возможностей, консультанты с AI ошибались на 19 процентных пунктов чаще коллег, работавших в одиночку. Многие просто перестали проверять. Исследование неровной границы возможностей
Исследователи назвали эту линию неровной границей (jagged frontier). Интуитивно ждёшь ровного круга: простые задачи внутри, трудные снаружи. В реальности линия ломаная. В 2025 году AI-системы вышли на уровень золотой медали Международной математической олимпиады — и в том же семействе моделей встречались сбои в подсчёте букв в слове. Модель способна составить убедительную аргументацию и тут же ошибиться при подсчёте объектов на фото, растерять детали в длинной переписке или не суметь сказать «не знаю».
| Просто для человека | Сложно для человека | |
|---|---|---|
| AI часто справляется | Ожидаемые сильные стороны • Вежливое деловое письмо • Выжимка по понятному отчёту |
Неожиданная сила • Олимпиадная математика • Поиск связей между областями |
| AI часто ошибается | Неожиданные слабые места • Подсчёт объектов на фото • Фраза «я не знаю» • Редкое исключение в длинном документе |
Трудно для обоих • Подлинно новая стратегия на неясном рынке |
Работать с этой границей мешают три свойства:
- Она не совпадает с вашим «сложно / просто». Житейское чутьё здесь плохой советчик.
- Она постоянно сдвигается, и рывками. Стоит подтянуть один недостающий поднавык — и способность появляется внезапно. Прошлогодние ограничения плохо предсказывают нынешние. Исследование эмерджентных способностей и критический взгляд на них.
- Готовой карты не существует. Вы нащупываете её для своих задач только проверкой на практике.
Ловушка Тома — излишняя уверенность: именно так консультанты заснули за рулём. Ловушка Ирины — отторжение алгоритмов (algorithm aversion): один сбой, зачастую на устаревшей модели, и вся технология списывается со счетов. Зрелое AI-мышление удерживает обе правды разом: инструмент по-настоящему силён и по-настоящему ненадёжен. Навык в том, чтобы различать, с чем вы имеете дело прямо сейчас.
Чат — это сборка, а не просто модель
«Но разве чат не может просто заглянуть в документы или интернет?» — спросил Том. Иногда может.
Современный чат — это модель плюс обвязка вокруг неё: программы, которые умеют искать в сети, открывать приложенные файлы, считать на калькуляторе и решать, что именно положить перед моделью. Когда модель сама выбирает такие действия, оценивает результат и продолжает работу дальше, эту систему называют агентом. Разница между фиксированными сценариями и агентами.
Но перед Анной устояли два ограничения. Интернет ничего не знает про её пятницу. Ни один поисковик не в курсе, когда её отдел закроет заявку № 2417. И модель работает только с тем, что лежит прямо сейчас у неё на рабочем столе. Вся текущая беседа — сама задача, факты, приложенные файлы и ответы инструментов — образует контекст. Если решающего факта на этом столе нет, модель аккуратно закрасит пробел гладкими словами. Про этот рабочий стол и про то, как с него незаметно соскальзывают важные детали, — история второго выпуска.
Две линии защиты
Уговаривать модель «не выдумывай» ненадёжно: для неё это просто ещё пара слов в потоке текста. Работает связка из двух привычек.
1. На входе: дайте модели законный выход для неизвестного.
Напиши короткий ответ заявителю строго по заметкам ниже.
Сохрани все три факта. Не добавляй сроки, цифры или обещания,
которых нет в заметках. Если срок завершения неизвестен, так и напиши.

Заметки:
Заявка получена.
Проверка продолжается.
Срок завершения не назначен.
Попробуйте сейчас (2 минуты). Запустите этот вариант в новом чате и сравните оба ответа рядом. Что исчезло?
Типичное сравнение «до и после»:
- Без права на «неизвестно»: «Мы рассчитываем направить вам итоги в ближайшие несколько рабочих дней… ваша заявка для нас в приоритете».
- С правом на «неизвестно»: «Ваша заявка получена и находится на рассмотрении. Срок завершения проверки пока не назначен».
Как только модели прямо разрешено назвать отсутствие даты, выдуманные сроки и дежурная лесть исчезают.
2. На выходе: проверьте три маркера риска. Положите исходник рядом с черновиком и пробегитесь глазами ровно по трём вещам: цифрам, датам и обязательствам. Каждый из них должен вести к конкретной строке источника.
- Где в заметках «в пятницу»? Нигде. Убираем.
- Где «мы завершим проверку»? Тоже нет. Возвращаем фактический статус.
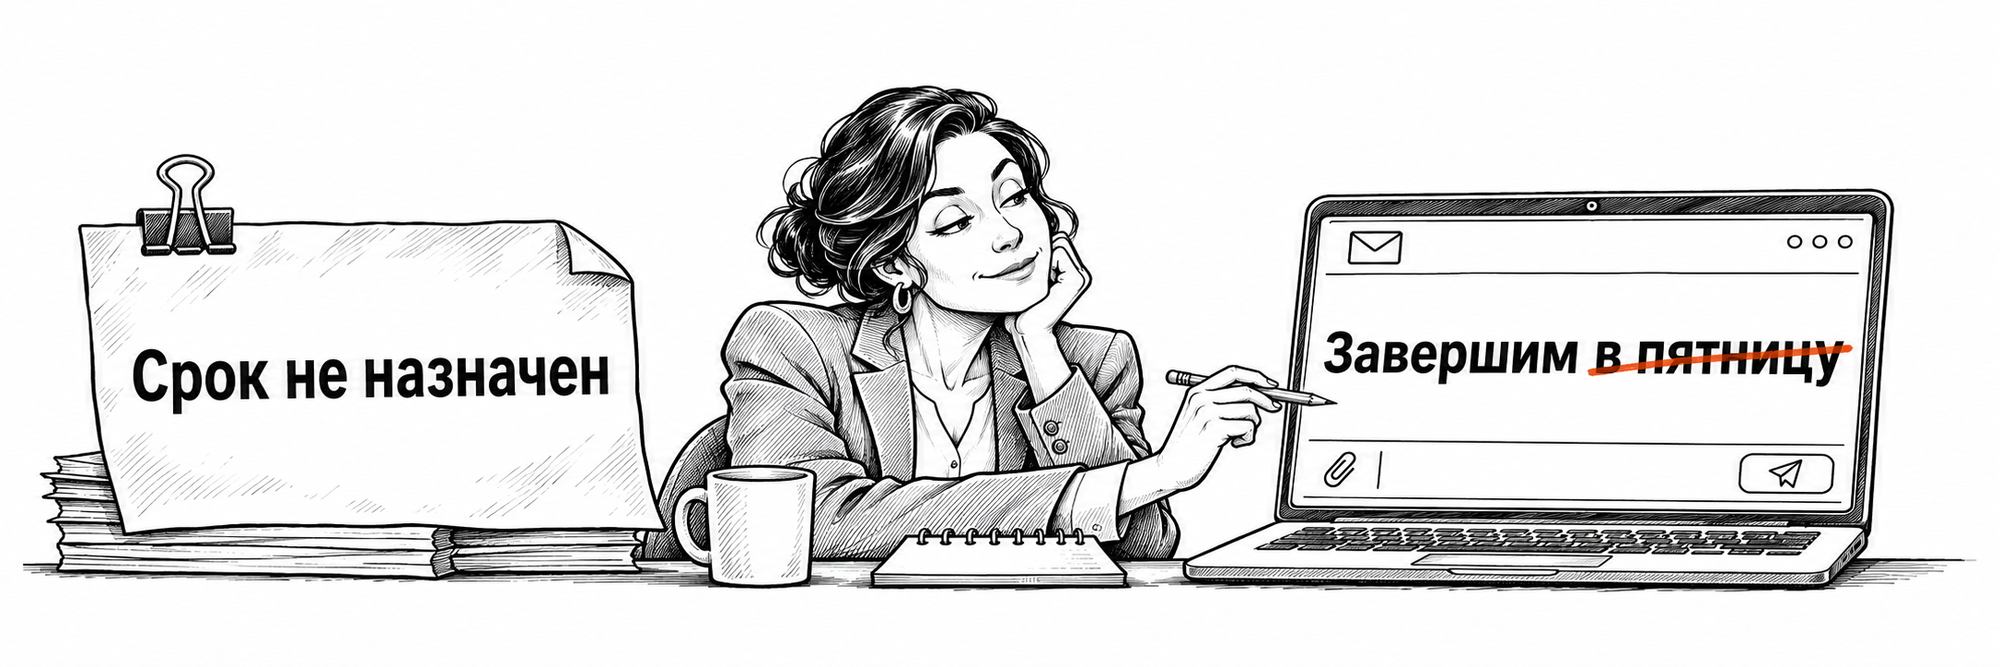
Остаётся текст, под которым Анна может спокойно поставить подпись:
«Мы получили вашу заявку, проверка продолжается. Срок завершения пока не назначен».
Тридцать секунд. Это и есть первая рабочая привычка AI-мышления.
Сдвиг 1: от оракула к движку. Языковая модель — не база данных и не всезнающий эксперт, который проверил факты. Это исключительно способный генератор правдоподобных продолжений, обученный играть роль старательного помощника. Его способности неровны: он блестяще решает то, что кажется трудным, и спотыкается на том, что выглядит элементарным. Поэтому два вопроса нельзя смешивать: «Хорошо ли это звучит?» и «Откуда мы это знаем?»
Практика: пропавшая дата
Напишите четыре-пять предложений о том, что встречу перенесли, и объясните причину, но не называйте новую дату. Попросите AI вытащить «причину и новую дату» в таблицу из двух столбцов.
Хороший ответ оставит ячейку даты честной: «не указана». Слабый подставит что-то правдоподобное вроде «на следующей неделе» или «ориентировочно в понедельник». Если модель справилась с первой попытки, перефразируйте текст, добавьте отвлекающую деталь (упомяните другое совещание в четверг) и попробуйте снова. Затем добавьте законный выход («если дата не указана, напиши „не указана“») и посмотрите, что изменится.
Запомните, как выглядит такая ошибка вживую — именно на неё вы и настраиваете взгляд.
Следующий выпуск
Во втором выпуске («Что видит модель»): что модель видит на самом деле, что незаметно падает с её рабочего стола и как готовить документы так, чтобы нужная деталь действительно нашлась.
AI: Фундамент — содержание серии
- Что находится по ту сторону окна чата: как языковая модель собирает ответ, почему AI бывает гениален и небрежен в один день и какие две привычки ловят придуманные обещания.
- Что видит модель: рабочий стол модели, что на самом деле значит «она запомнила» и как оформлять материалы, чтобы находилась нужная деталь.
- Как ставить задачу: почему волшебные слова перестали работать и из чего на самом деле состоит ясное задание.
- Доверяйте проверке, а не тону: откуда берутся убедительные ошибки, почему AI вам льстит и на какую внешнюю опору опираться при проверке.
- Как делегировать: когда передача работы AI окупается, как ставить задачу агенту и как не дать его ошибкам превратиться в действия.
- Оставаться в контуре: как учиться с AI, не теряя собственных навыков, и какие человеческие качества дорожают по мере роста моделей.
Только работающие инструменты
Раз в неделю — практические приёмы и шаблоны, проверенные в реальной работе.